CUDA by example 2
Posted on: Juni 18, 2013
lasung saja ke bukunya sbuah buku yang menjelaskan CUDA dengan caranya
ini adalah buku tetang cuda terbaru
dan slama membca dan mencobanya 😀
CUDA by Example
Posted on: Juni 18, 2013
cuda dimana cara mengorasi pada gpu hanya 1 saja yang di jelaskan
CUDA Tutorial – 3d vertex transformations
Vertex transformations are an extremely common operation for both 2d and 3d programs. A transformation can include translation, rotation, scaling, or any combination of the three. While it is beyond the scope of this article to elaborate on fine details of vertex transformations, it all boils down to a matrix multiplication. A 3d vertex can be represented as a 1×4 matrix, [x, y, z, w] where w is usually 1, and the transformation is represented as a 4×4 matrix. To get the translated vertex, you simply need to multiply the vertex by the transformation matrix, where the result is also a convenient 1×4 matrix. For a more detailed explanation, you can read about the transformation matrix here.
Why use CUDA for 3d vertex transformations
Because a transformation is basically just a matrix multiplication, the problem is perfectly suited for CUDA. Sure, the computation for each vertex only requires 16 multiplications and 12 additions, but it is very common to have 3d models with tens, or hundreds of thousands of vertices. Large projects like James Cameron’s Avatar could easily require hundreds of millions of vertices in a single scene, all of which need to be transformed into their final positions before being rendered. CUDA’s strength lies in it’s massive compute capabilities, which can be fully exercised when presented with a large number of vertices to be transformed. Another reason why CUDA is suited well for 3d transformations is it’s sheer memory bandwidth. High end GPUs can have 10 times higher memory bandwidth than a high end CPU from Intel or AMD. This fact helps in cases like this where only a few computations are needed per vertex transformation.
The code
The code for 3d vertex transformations for CUDA is fairly simple. In fact, we don’t need to do any fancy work at all. The kernel will have three parameters, float *vertices, float *transformMatrix and nVertices. The vertices array is our global array of vertices. Each vertex is represented by four floats. This array is also where the results are stored. While this may work for many applications, if you want to preserve the original vertex data you would need to create another array to store the results. The transformMatrix is the other parameter, which stores a single, 4×4 matrix as an array of 16 floats.
Determining the number of threads and blocks to run
The code to determine how many threads and blocks to run is below. This isn’t really the best way to do it, but it’s a non-critical piece of code as far as speed is concerned. The code to execute the kernel is also below.
// setup execution parameters
int nBlocksX = 1;
int nBlocksY = 1;
if (num_threads > 512)	// best for backwards compatibility
{
	nBlocksX = (num_threads/512) + 1;
	num_threads = 512;
	if (nBlocksX > 65535)	// best for backwards compatibility
	{
		nBlocksY = (nBlocksX/65535) + 1;

		nBlocksX = 65535;
	}
}
dim3 grid(nBlocksX, nBlocksY, 1);
dim3 threads(num_threads, 1, 1);

// execute the kernel
ThreeDVertexTransform<<< grid, threads >>>(d_vertices, d_transformMatrix, curNumVertices);

// check if kernel execution generated and error
getLastCudaError("Kernel execution failed");
Kernel code
__global__ void ThreeDVertexTransform(float *vertices, float *transformMatrix, int nVertices)
{
	// each thread will compute exactly one number
	// four numbers per vertex [x,y,z,w] means 4 threads will compute exactly
	// one vertex transformation

	// each block must be 1-D, with the number of threads being a multiple of 4 (32 is best)
	// grid of blocks may be 1-D or 2-D to accomodate a very large number of vertices
	// compute the current thread ID
	// Each thread will compute the new vertices[tid]
	int tid = (blockIdx.y * gridDim.x * blockDim.x) +
					(blockIdx.x * blockDim.x) +
					(threadIdx.x);

	// perform checking to prevent buffer overruns
	if (tid > nVertices*4) return;
	// are we calculating x,y,z, or w?
	int subId = threadIdx.x % 4;
	float sum = vertices[tid-subId] * transformMatrix[subId];
	sum += vertices[tid-subId+1] * transformMatrix[4+subId];
	sum += vertices[tid-subId+2] * transformMatrix[8+subId];
	sum += vertices[tid-subId+3] * transformMatrix[12+subId];
	vertices[tid] = sum;
}
Results
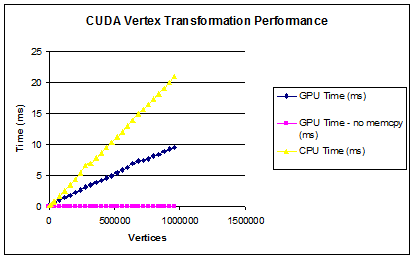
The machine used for testing has an Intel i7-930 CPU, and a GTX 460 graphics card. There are three tests run. One test just did the vertex transformations using the CPU. This test was single-threaded. I also tried multithreaded with OpenMP, but there was little improvement, indicating the bottleneck was not the number of CPU cores, but some part of the memory and cache system. Another test was used with the GPU, and included copying data to and from the GPU. If you have a problem where vertex data isn’t already on the GPU, you would need to copy the data to the GPU’s global memory first. Finally, a test was performed which measured the kernel runtime only, and didn’t include memory transfers from or two the host’s main memory. Notice that the actual kernel runtime is extremely low. So if you have a problem where you can permanently keep all your problem data on the GPU, you could achieve a massive speed up when compared to the CPU. However, if you need to copy data back and forth every single time, your speedup will only be around 2x. One last thing to note is that the GPU became lower runtime than the CPU even with all the memory copies for as few as 8192 vertices.
CUDA 5
Posted on: Juni 18, 2013
NVIDIA CUDA Peluncuran 5
NVIDIA hari ini membuat NVIDIA CUDA tersedia 5 rilis produksi, versi baru yang kuat dari platform komputasi paralel paling luas di dunia dan model pemrograman untuk mempercepat aplikasi ilmiah dan rekayasa pada GPU. Hal ini dapat didownload secara gratis dari situs Zone NVIDIA Developer. Dengan lebih dari 1,5 juta download, mendukung lebih dari 180 rekayasa terkemuka, aplikasi ilmiah dan komersial, model pemrograman CUDA adalah cara yang paling populer bagi para pengembang untuk mengambil keuntungan dari komputasi GPU-accelerated.
Bangunan pada keberhasilan ini, fitur pemrograman baru dari 5 Platform CUDA membuat pengembangan aplikasi GPU-accelerated lebih cepat dan lebih mudah dari sebelumnya, termasuk dukungan untuk paralelisme dinamis, perpustakaan GPU-callable, NVIDIA GPUDirect dukungan teknologi untuk RDMA (akses memori langsung jarak jauh ) dan NVIDIA Nsight Eclipse Edition lingkungan pengembangan terpadu (IDE)
Penghargaan pengembang untuk CUDA 5
Pengembang yang dievaluasi versi pre-release dari CUDA 5 telah melaporkan sering dramatis percepatan aplikasi dan meningkatkan programabilitas. Industri pertahanan dan kedirgantaraan menyadari manfaat dari akselerasi GPU CUDA untuk pengolahan gambar, data video dan sensor, seperti radar. Menurut Dustin Franklin, aplikasi GPGPU insinyur di GE Cerdas Platform di Charlottesville, Va, “CUDA 5 adalah teknologi penting bagi kami. Banyak aplikasi yang kami gunakan melibatkan data streaming sensor langsung ke GPU dengan latency rendah, sehingga GPUDirect dukungan untuk RDMA pada baru Kepler GPU adalah sangat penting bagi pelanggan kami. kami memiliki dukungan terintegrasi untuk banyak sensor kustom sudah dan sangat senang dengan hasilnya. ”
Guillaume Belz, seorang ahli biokimia penelitian di Lyon University Hospital di Lyon, Prancis, telah menggunakan paralelisme dinamis dan perpustakaan GPU-callable untuk analisis sinyal kompleks dan data mining. “Dengan akselerasi GPU, kita bisa mendapatkan hasil dalam beberapa jam untuk proyek-proyek yang digunakan untuk meminta minggu atau bahkan berbulan-bulan dengan CPU saja. Tanpa akselerasi GPU, analisis tidak mungkin sama sekali,” kata Belz.
Weihua (Wayne) Sun, Ph.D. kandidat dalam ilmu pencitraan di Rochester Institute of Technology di New York, terkesan dengan NVIDIA Nsight Eclipse Edition. “Ketika saya belajar bahwa CUDA 5 termasuk baru Nsight Eclipse IDE Edition, aku tahu aku membutuhkannya segera. Memiliki semua program saya, debugging dan optimasi alat dalam satu lingkungan pengembangan terpadu adalah meningkatkan produktivitas yang besar bagi saya.”
Fitur terbaru CUDA 5
CUDA 5 memungkinkan pengembang untuk mengambil keuntungan penuh dari kinerja GPU NVIDIA, termasuk akselerator GPU didasarkan pada NVIDIA Kepler menghitung arsitektur – tercepat, paling efisien, arsitektur komputasi kinerja tertinggi yang pernah dibangun. Fitur utama meliputi:
. Dinamis Paralelisme – Membawa akselerasi GPU untuk algoritma baru. Benang GPU secara dinamis dapat menelurkan thread baru, yang memungkinkan GPU untuk beradaptasi dengan data. Dengan meminimalkan bolak-balik dengan CPU, paralelisme dinamis sangat menyederhanakan pemrograman paralel. Dan itu memungkinkan akselerasi GPU dari satu set yang lebih luas dari algoritma populer, seperti yang digunakan dalam perbaikan mesh adaptif dan dinamika fluida komputasi aplikasi.
. Perpustakaan GPU-Callable – Memungkinkan ekosistem pihak ketiga. Sebuah baru CUDA BLAS library memungkinkan pengembang untuk menggunakan paralelisme dinamis untuk sendiri perpustakaan GPU-callable mereka. Mereka dapat merancang plug-in API yang memungkinkan pengembang lain untuk memperluas fungsionalitas dari kernel mereka, dan memungkinkan mereka untuk mengimplementasikan callback pada GPU untuk menyesuaikan fungsi pihak ketiga perpustakaan GPU-callable. The “objek yang menghubungkan” kemampuan menyediakan proses yang efisien dan akrab untuk mengembangkan aplikasi GPU besar dengan memungkinkan pengembang untuk mengkompilasi beberapa file sumber CUDA ke file objek yang terpisah, dan menghubungkan mereka ke dalam aplikasi yang lebih besar dan perpustakaan.
• GPUDirect Dukungan untuk RDMA – sistem kemacetan memori Meminimalkan. GPUDirect teknologi memungkinkan komunikasi langsung antara GPU dan perangkat PCI-E lainnya, dan mendukung akses memori langsung antara kartu antarmuka jaringan dan GPU. Hal ini juga secara signifikan mengurangi latency MPISendRecv antara node GPU dalam sebuah cluster dan meningkatkan kinerja aplikasi secara keseluruhan.
NVIDIA Nsight Eclipse Edition – Hasilkan kode CUDA dengan cepat dan mudah.
NVIDIA Nsight Eclipse Edition memungkinkan programmer untuk mengembangkan, debug dan aplikasi GPU profil dalam IDE berbasis Eclipse akrab di Linux dan Mac OS X platform. Sebuah CUDA terintegrasi Editor dan sampel CUDA mempercepat generasi CUDA kode, dan refactoring kode otomatis memudahkan porting CPU loop untuk CUDA kernel. Sebuah sistem analisis pakar terintegrasi menyediakan analisis kinerja otomatis dan panduan langkah-demi-langkah untuk memperbaiki hambatan kinerja dalam kode, sedangkan sintaks memudahkan untuk membedakan kode GPU dari kode CPU.
NVIDIA GPU
Posted on: Juni 18, 2013
GPU di NVDIA yang sudah mensuport CUDA yang baru saya dengar atau baru saya tau ada 3 yaitu tesla ,kepler,dan fermi langsung saja penjelasan
tesla
Tesla graphics processing unit (GPU) adalah merek ketiga Nvidia GPU. Hal ini didasarkan pada GPU high-end dari G80 (dan), serta lineup Quadro. Tesla Nvidia pertama yang didedikasikan General Purpose GPU. Seri Tesla mengambil nama dari perintis insinyur listrik Nikola Tesla.
Perbedaan utama antara kartu Tesla berbasis Fermi dan seri GeForce 500 adalah kinerja terkunci ganda presisi floating-point memberikan 1/2 kinerja floating point presisi tunggal puncak dalam kartu Tesla dibandingkan dengan 1/8 untuk kartu GeForce. Selain itu, kartu Tesla memiliki memori ECC yang dilindungi dan tersedia dalam model dengan tinggi memori on-board (hingga 6GB).
Karena kekuasaan yang sangat tinggi komputasi mereka (diukur dalam operasi floating point per detik atau FLOPS) dibandingkan dengan mikroprosesor sebelumnya, Tesla produk target pasar komputasi kinerja tinggi. Pada 2012, Nvidia Teslas kekuatan beberapa superkomputer tercepat di dunia, termasuk Titan di Oak Ridge National Laboratory dan Tianhe-1A, di Tianjin, Cina.
Kurangnya kemampuan untuk output gambar ke layar adalah perbedaan utama antara produk Tesla dan tingkat kartu GeForce konsumen dan tingkat kartu Quadro profesional, tapi Tesla C-class produk terbaru termasuk satu Dual-link DVI port. Untuk output presisi tunggal setara, Fermi berbasis Nvidia GeForce kartu memiliki empat kali lebih sedikit kinerja dual-presisi. Produk tesla terutama beroperasi: dalam simulasi dan perhitungan skala besar (terutama perhitungan floating-point),untuk generasi gambar high-end untuk aplikasi di bidang profesional dan ilmiah, dengan menggunakan OpenCL atau CUDA.
Nvidia bermaksud menawarkan ARMv8 core prosesor tertanam ke depan Tesla GPU sebagai bagian dari Denver.This Proyek akan menjadi 64-bit mengikuti pada ke 32-bit chip Tegra. Tesla sendiri akan diikuti oleh TB / s Volta pada tahun 2016.
Specifications and configurations
|
Configuration |
Model |
# of GPUs |
Core clock |
Shaders |
Memory |
Processing Power (peak) |
Compute capability4 |
TDP watts |
Form factor |
|||||||
|
Thread Processors (total) |
Clock in MHz (each) |
Bandwidth max (GB/s) |
Bus type |
Bus width (bit, each GPU) |
Total size (MiB) |
Clock (MHz) |
Single Precision (SP) Total (MUL+ADD+SF) |
Single Precision (SP) MAD (MUL+ADD) |
||||||||
| GPU Computing Processor1 |
C870 |
1 |
600 |
128 |
1350 |
76.8 |
GDDR3 |
384 |
1536 |
1600 |
518.4 |
345.6 |
0 |
1.0 |
170.9 |
Full-height video card |
| Deskside Supercomputer1 |
D870 |
2 |
600 |
2 × 128 (256) |
1350 |
153.6 |
GDDR3 |
384 |
3072 |
1600 |
1036.8 |
691.2 |
0 |
1.0 |
520 |
|
| GPU Computing Server1 |
S870 |
4 |
600 |
4 × 128 (512) |
1350 |
307.2 |
GDDR3 |
384 |
6144 |
1600 |
2073.6 |
1382.4 |
0 |
1.0 |
||
| C1060 Computing Processor 2 |
C1060 |
1 |
602 |
240 |
1300 |
102.4 |
GDDR3 |
512 |
4096 |
1600 |
933.12 |
622.08 |
77.76 |
1.3 |
187.8 |
2 slot video card |
| S1075 1U GPU Computing Server3,4 |
S1070 |
4 |
602 |
4 × 240 (960) |
1440 |
409.6 |
GDDR3 |
512 |
16384 |
1600 |
4147.2 |
2764.8 |
345.6 |
1.3 |
1U Rack |
|
| C2050/C2070/C2075 GPU Computing Processor
|
C2050/C2070/C2075 |
1 |
575 |
448 |
1150 |
144 |
GDDR5 |
384 |
3072/61445 |
1500 |
1288 |
1030.46 |
515.2 |
2.0 |
238/247/225 |
Full-height video card |
| M2050 GPUComputing Module |
M2050 |
1 |
575 |
448 |
1150 |
148.4 |
GDDR5 |
384 |
30725 |
1546 |
1288 |
1030.46 |
515.2 |
2.0 |
225 |
Computing Module |
| M2070/M2070Q[11] GPU Computing Module |
M2070/M2070Q |
1 |
575 |
448 |
1150 |
150.336 |
GDDR5 |
384 |
61445 |
1566 |
1288 |
1030.46 |
515.2 |
2.0 |
225 |
Computing Module |
| M2090 GPU Computing Module |
M2090 |
1 |
650 |
512 |
1301 |
177 |
GDDR5 |
384 |
61445 |
1848 |
? |
1332.2 |
666.1 |
2.0 |
225 |
Computing Module |
| S2050 1U GPU Computing System |
S2050 |
4 |
575 |
4 × 448 (1792) |
1150 |
4 × 148.4 (593.6) |
GDDR5 |
384 |
122885 |
3092 |
5152 |
4121.66 |
2060.8 |
2.0 |
900 |
1U Rack |
| K10 GPU Computing Module |
K10 / GK104 |
2 |
745 |
1536 per GPU |
256 per GPU |
160 per GPU |
GDDR5 |
– |
4096 per GPU |
2500 |
2288 per GPU |
– |
95 per GPU |
3.0 |
225 |
Computing Module |
| K20 GPU Computing Module |
GK110 |
1 |
745 |
2496 |
706 |
208 |
GDDR5 |
384 |
5120 |
2560 |
3520 |
– |
1170 |
3.5 |
225 |
Computing Module IEEE 754-2008 FMA capabilities |
| K20X GPU Computing Module |
GK110 |
1 |
735 |
2688 |
732 |
250 |
GDDR5 |
384 |
6144 |
5200 |
3950 |
384 |
1310 |
3.5 |
235 |
Computing Module IEEE 754-2008 FMA capabilities |
kepler
NVIDIA GeForce GTX 680
Arsitektur
|
s |
|
GK104 Block Diagram |
Untuk Nvidia GTX 680 ini sudah menggunkan chipset yang lebih “anyar” dari seri sebelumnya yaitu GTX 580. Nvidia GTX 680 ini menggunakan chipset GK104 dengan arsitektur generasi terbaru penerus Fermi dengan code name yang sudah familiar yaitu Kepler. Untuk chip dari GTX 680 yaitu chip GK104 terdiri dari 4 buah blok GPC dengan 2 blok Streaming Multiprocessor di dalamnya. Kalo pada teknologi Fermi untuk istilah Streaming Multiprocessor dinamakan SM, namun untuk generasi teknologi Kepler ini dinamakan dengan SMX. SMX ini diklaim memiliki kemampuan atau watt dua kali lipat lebih baik dibanding SM yang merupakan Streaming Multyprocessor sebelumnya.
|
GF110 Block Diagram |
Pada chip GPU GF110, di setiap blok Streaming Multiprocessor terdapat 32 CUDA Cores. Sedangkan pada chip GPU GK104, terdapat 192 CUDA Cores di setiap blok Streaming Multiprocessor (enam kali lipat lebih banyak dibandingkan chip GPU GF110). Dengan jumlah blok SMX sebanyak delapan buah, chip GPU GK104 memiliki CUDA Cores sebanyak 1536 buah.
|
GK104 Die Shot |
chipset GK104 ini memiliki transistor sebanyak 3.54 miliar. Walaupun mengalami peningkatan jumlah dari chipset sebelumnya namun untuk uuran luas die GK104 mengalami pengurangan menjadi 294 mm2 berkat penggunaan proses fabrikasi 28nm.
Dibandingkan chip GPU GF110, chip GK104 memiliki 1536 CUDA Core (tiga kali lipat lebih banyak) dan 128 Texture Units (dua kali lipat lebih banyak). Akan tetapi ternyata terdapat pengurangan pada ROP Units dari 48 buah menjadi 32 buah.
NVIDIA GTX 680 memiliki spesifikasi clock lebih tinggi dibandingkan NVIDIA GTX 680. Clock GPU ini adalah 1006 MHz dan memori clock berada pada angka 6008 MHz. Selain clock GPU, Shader, dan memori, NVIDIA GTX 680 kini dilengkapi boost clock yang berada pada angka 1056 MHz.
NVIDIA GTX 680 kini dilengkapi kapasitas memori sebesar 2GB dengan tipe memori GDDR5. NVIDIA GTX 680 kini menggunakan bandwidth memory lebih rendah dibandingkan NVIDIA GTX 580 yaitu 256-bit.
fermi
CUDA Compute dan Grafis Arsitektur, Kode-Bernama “Fermi” Arsitektur Fermi adalah lompatan yang paling maju yang signifikan dalam arsitektur GPU
Sejak G80 asli. G80 adalah visi awal kita tentang apa grafis terpadu dan komputasi paralel prosesor akan terlihat seperti. GT200 diperpanjang kinerja dan fungsi dari G80. Dengan Fermi, kita telah mengambil semua yang telah kita pelajari dari dua prosesor sebelumnya dan semua aplikasi yang ditulis untuk mereka, dan menggunakan pendekatan yang sama sekali baru untuk merancang untuk menciptakan pertama komputasi dunia GPU. Ketika kita mulai meletakkan dasar untuk Fermi, kami mengumpulkan umpan balik pengguna yang ekstensif pada komputasi GPU sejak diperkenalkannya G80 dan GT200, dan terfokus pada bidang utama berikut untuk perbaikan:
• Meningkatkan Presisi ganda Kinerja sementara tunggal kinerja floating point presisi berada di urutan sepuluh kali kinerja desktop CPU, beberapa komputasi GPU aplikasi yang diinginkan kinerja lebih presisi ganda juga.
• ECC dukungan ECC memungkinkan pengguna komputasi GPU untuk aman menyebarkan sejumlah besar GPU dalam instalasi datacenter, dan juga memastikan aplikasi data-sensitif seperti pencitraan medis dan keuangan harga opsi dilindungi dari kesalahan memori.
• Benar-Cache Hirarki beberapa algoritma paralel tidak dapat menggunakan memori GPU bersama, dan pengguna diminta arsitektur cache yang benar untuk membantu mereka.
• Lebih Memori Bersama-banyak CUDA programmer meminta lebih dari 16 KB dari SM bersama memori untuk mempercepat aplikasi mereka.
• Konteks Cepat Switching-pengguna diminta konteks switch cepat antara aplikasi
program dan grafis yang lebih cepat dan menghitung interoperation
. • Cepat Atom Operasi-pengguna diminta lebih cepat read-memodifikasi-menulis operasi atom untuk algoritma paralel mereka.
Dengan permintaan ini dalam pikiran, tim Fermi merancang prosesor yang sangat meningkatkan baku menghitung tenaga kuda, dan melalui inovasi arsitektur, jugamenawarkan dramatis meningkat programabilitas dan efisiensi menghitung. Highlights arsitektur Fermi utama adalah:
• Generasi Ketiga Streaming Multiprocessor (SM)
o 32 CUDA core per SM, 4x lebih GT200
o 8x puncak kinerja floating point presisi ganda lebih GT200
o Ganda Warp Scheduler bersamaan jadwal dan instruksi kiriman
dari dua warps independen
o 64 KB RAM dengan partisi dikonfigurasi memori bersama dan cache L1
• Generasi Kedua Paralel Thread Eksekusi ISA
o Bersatu Ruang Alamat Lengkap dengan C + + Dukungan
o Dioptimalkan untuk OpenCL dan DirectCompute
o Lengkap IEEE 754-2008 presisi 32-bit dan 64-bit
o penuh 32-bit integer jalan dengan ekstensi 64-bit
o instruksi akses memori untuk mendukung transisi ke 64-bit
o Peningkatan Kinerja melalui Prediction
• Peningkatan Subsistem Memori
o NVIDIA Paralel DataCacheTM hirarki dengan L1 Dikonfigurasi dan Bersatu L2
Cache
o Pertama GPU dengan dukungan memori ECC
o Sangat meningkatkan kinerja operasi memori atom
• NVIDIA GigaThreadTM Mesin
o 10x lebih cepat konteks aplikasi beralih
o serentak kernel eksekusi
o Out of Order benang eksekusi blok
o Ganda tumpang tindih memori perpindahan mesin
sejarah gpu
Posted on: Juni 18, 2013

pada awal gpu di buat oleh IBM engan nama IBM PC video card pada tahun 1981. Saat itu istilahnya MDA (Monochrome Display Adapter) dan hanya bisa beroperasi untuk text mode dengan ukuran 80 kolom 25 baris (80×25). Mempunyai video memory sebesar 4KB dan cuma mensupport 1 warna.
dengan kemunculan MDA itulah kemudian bermunculan beberapa kartu grafik. Kesuksesan VGA menarik minat beberapa perusahaan seperti ATI, Cirrs Logic dan S3 untuk mengembangkan teknologi ini dengan meningkatkan kemampuan resolusi dan jumlah warna. Hal ini melahirkan teknologi resolusi standar SVGA (Super VGA) , dengan resolusi 1024×768, 256 warna dan memory 2MB.
Tahun 1995 muncul ke pasaran kartu grafis 2D/3D yang dikembangkan oleh Matrox, Creative, S3, ATI dll. Kartu grafis ini mengikuti standar SVGA tapi sudah mendukung teknologi 3D.
dan tahon 1997 3dfx mengeluarkan Voodoo graphic chip yang lebih kuat dari kartu grafis lainnya pada saat itu, dengan memperkenalkan teknologi 3D effects seperti mip mapping, Z-buffering dan anti-aliasing. Setelah kemunculan Voodoo, kartu grafis 3D lainnya bermunculan seperti Voodoo2 dari 3dfx, TNT dan TNT2 buatan Nvidia.
Bandwidh yang dibutuhkan oleh kartu-kartu grafis ini mendekati limit kapasitas PCI bus pada saat itu. Intel mengembangkan AGP (Accelerated Graphics Port) yang memecahkan permasalahan bottleneck antara microprocessor dan kartu grafis. Dari tahun 1999 sampai 2002, Nvidia menguasai pasaran kartu grafis (mengalahkan 3dfx) dengan produk GeForce-nya.
Sejak tahun 2003, ATI dan Nvidia mendominasi pasaran kartu grafis dengan produk Radeon dan GeForce mereka dengan jumlah hampir 90%.
tetapi disini akan mengenal tentang GPU pada NVIDIA di karenakan asal mula pemrogreaman paralel cuda
Review game
Posted on: April 25, 2012
di sini saya akan mereview game tentang FF 12 (final fantasy 12)
Dunia yang disebut Ivalice …
Zaman ketika tenung adalah biasa dan airships menumpuk langit …
Kisah kita dimulai.
Sementara perang tenun di cakrawala, Kekaisaran Archadian perkasa mulai kampanye untuk menundukkan tetangga-tetangganya. Kerajaan kecil Dalmasca berbagi nasib mereka.
Dua tahun setelah, jatuh di ibukota Rabanastre line, orang jalan-jalan untuk menunggu pengangkatan dari counsul baru dari Archadia.
Untuk Vaan, seorang pemuda yang hidup di jalanan dari Rabanastre, Emprire adalah musuh yang dibenci yang mengambil kehidupan saudaranya, satu-satunya keluarga yang ditinggalkannya. Vaan menetas plot untuk masuk ke istana dan mengambil kembali barang rampasan penaklukan dari penjajah Dalmasca itu.
Ia mendapat lebih dari yang menawar ketika ia bertemu Putri Ashe, pewaris tunggal untuk bertahan tahta Dalmascan, pikir mati sejak perang.
Cerita berikut Ashe, Vaan, dan temannya Penelo, bajak laut langit Balthier dan rekannya Fran. Mendampingi mereka adalah Basch, seorang kapten dari tentara Dalmascan.
Petualangan ini mencakup Ivalice dan jejak misteri di balik invasi Kekaisaran Archadian itu.
plot
Final Fantasy XII terjadi sebagian besar di kerajaan Dalmasca, negara kota yang kecil di dunia Ivalice. Sebuah partai netral dalam perang masa lalu antara kerajaan-kerajaan tetangga dari Archadia dan Rosaria, Dalmasca akhirnya ditaklukkan oleh Archadia dan dikurangi menjadi status sebuah negara yang diduduki di bawah kekuasaan Archadian. Vaan, sebuah jalan urchin yang hidup di ibukota Dalmascan dari Rabanastre, mencuri harta beberapa dari kediaman Konsul Archadian di istana kerajaan lama Dalmasca. Sementara penjarahan Vaan aman kastil memenuhi Balthier, bajak laut langit bertekad mencuri harta Konsul dan rekannya Fran, seorang prajurit Viera. Secara kebetulan dalam serangan gerakan bawah tanah Dalmascan perlawanan benteng kerajaan di malam yang sama, untuk menggulingkan Konsul Archadian. Penjarahan Vaan yang akan melihat dan dia, Fran dan Balthier dikejar oleh tentara Archadian, bersama dengan para pemberontak menyerbu benteng, membuat mereka tampaknya terlibat dalam serangan itu. Ini akhirnya membawa wajah tiga muka dengan Ashe, sang putri digulingkan dari Dalmasca dan pemimpin faksi perlawanan.
Balthier, Vaan dan Fran dikirim ke penjara dari tempat mereka melarikan diri membawa Basch, yang telah di penjara sejak perang, dengan mereka. Headhunter mencari Balthier menculik Penelo sahabat Vaan dalam harapan bahwa Balthier selalu gagah akan mencoba untuk membebaskan gadis itu. Vaan, Fran, Basch dan kepala Balthier untuk Bhujerba untuk membebaskan Penelo dan memenuhi Larsa dalam petualangan mereka di sana. Larsa ini revelaed menjadi pewaris kerajaan, yang kedua dalam antrian untuk tahta Archadia. Dia membantu partai Penelo penyelamatan dan kemudian membuat dia dan aman pihak dari pasukan Archadian. Pada Bhujerba partai memenuhi Ashe lagi dan ia meminta bantuan Baltier untuk mengambil bukti dari darah bangsawan-nya: The Dawn Shard.
Partai kepala ke Makam Raja Dinasti untuk mengambil Dawn Shard dan akan ditangkap oleh Ghis Hakim segera setelah mereka melakukannya. Sebuah ledakan besar misterius memberikan peluang bagi partai untuk melarikan diri. Selama pelarian mereka mereka menemukan – untuk horor mereka – bahwa Hakim Ghis Kapal dan armada 8 Seluruh Archdian dihancurkan oleh kekuatan Dawn Shard, dengan terdiri dari zat aneh yang disebut Nethicite. Bertekad memegang kekuasaan itu untuk bebas Dalmasca dan membalas kepala jatuh nya rekan Ashe ke tempat di mana dia bisa belajar lebih banyak tentang Batu. Secara kebetulan mereka bertemu Larsa lagi, yang membujuk mereka untuk bergabung dengannya dan lain musuh misterius / sekutu di Mt. Bur-Omisace untuk merencanakan tentang cara untuk menghentikan perang dekat.
Dipermalukan oleh kerusakan armada 8 ini, Vayne disebut kembali ke Archadia dan mulai mencurigai bahwa ayahnya dan Senat Archadian akan memotong dia untuk Raja, memberikan tahta untuk Larsa saudaranya sebagai gantinya. Tidak mau mengambil risiko dilewati dengan pembunuhan Vayne thrne ayahnya dan larut Senat dan segera mengirim kapal ke Mt. Bur-Omisace untuk menangkap Dawn Shard dari Ashe. Utusan-Nya, Hakim Bergan, tiba terlambat: Ashe dan Larsa mendengar tentang peristiwa dan Ashe telah memperoleh Pedang Dinasti, sementara Larsa kembali ke Archadia tergesa-gesa. Sebuah Bergan marah membunuh orang suci Gran Kiltias Anastasis dan Gunung bom. Bur Omisace tetapi tidak mampu untuk mendapatkan beling atau pedang.
Ashe dan partainya memutuskan sekarang saatnya untuk menghancurkan semua Nethicite tersedia di Ivalice dan kepala ke Draklor Labs di jantung Kekaisaran Archadian, dimana pecahan terakhir adalah, untuk menghancurkannya dan laboratorium di mana Dr Cid berhasil menggunakan apa yang telah belajar dari yang beling nethicite untuk memproduksi nethicite buatan.
Mereka tidak berhasil dalam menghancurkan Nethicite di Draklor Labs, dan malah pergi dengan informasi yang menunjuk mereka ke kota kuno Giruvegan. Dr Cid diduga pergi ke sana untuk mengambil lebih Deifacted (dewa dibuat) nethicite. Partai ini memasuki kota dan perkelahian dengan pusat Crystal Besar, sepotong sangat besar dan kuat dari Nethicite di mana Occurians hidup. Ada, sejarah Raithwall dan Nethicite terungkap. Ashe diberikan pisau Perjanjian sehingga ia bisa mengukir potongan tambahan nethicite Deifacted untuk mencapai kekuasaan yang lebih besar. Dia diperintahkan untuk menghancurkan Kekaisaran Archadian. Ashe yang bertentangan sebagai program nya tindakan, karena dia tidak ingin menghancurkan Larsa dan Archadians bersalah lainnya.
Ashe dan partai meninggalkan Giruvegan dengan pengetahuan bahwa Dr Cid telah menggunakan mereka untuk mengambil pisau Perjanjian, dan tidak berniat bepergian ke Giruvegan. Mereka kembali ke Balfonheim dan bajak laut bernama Reddas bergabung dengan partai untuk melakukan perjalanan ke Ridorana, dimana Cryst Sun ditempatkan di Pharos mercusuar. Dalam Ashe mercusuar Menyadari bahwa semua rupa Tuhan Rassler adalah gambar dibangun oleh Occurians. Hakim Gabranth tiba dan berkelahi dengan partai. Setelah Kekalahan, Dr Cid muncul dan mengusirnya kembali ke armada. Cid ingin menggunakan kekuatan Cryst Sun untuk membuat dirinya Tuhan sebelum Ashe menghancurkannya. Setelah mengalahkan Dr Cid, yang Cryst Sun mulai menghasilkan banyak kekuatan sehingga tidak ada cara bahwa partai bisa bertahan, sampai Reddas mengorbankan diri untuk menghancurkan Cryst Sun dengan Pedang Raja.
Partai perjalanan Vaan yang kembali ke Balfonheim dan belajar bahwa pembuangan listrik mengaktifkan pesawat terbesar yang pernah dibangun, Bahamut, dan pasukan perlawanan telah mengadakan pertempuran di langit di atas Rabanastre. Mereka melakukan perjalanan ke Bahamut untuk tanah dan membunuh Vayne sebelum ia dapat menghancurkan negara Dalmasca, dan semua kapal di armada. Sebelum mereka dapat mencapai Vayne, Gabranth tiba untuk menghentikan mereka. Kali ini, Gabranth tampaknya sudah menyerah semuanya kecuali kebutuhannya untuk menghancurkan saudaranya sendiri. Partai ini mengalahkan Gabranth dan meninggalkan dia dipukuli di lift. Vayne menyerang, dan Larsa membantu partai untuk melawan dia. Sebagai Vayne dipukuli bawah, nethicite Manufacted nya menyebalkan daya dari Larsa, dan kapal di sekitarnya. Gabranth bergabung dengan serangan terhadap Vayne, tetapi dihempaskan, seperti Vayne kehilangan kekuasaannya lebih besar. Para nakal Occuria Venat bergabung dengan Vayne memberikan dia lebih banyak kekuatan, dan partai sekali lagi serangan itu, menang kali ini.
game engine
Posted on: April 25, 2012
game engine adalah sistem yang dirancang untuk penciptaan dan pengembangan video game. Mesin game terkemuka memberikan kerangka perangkat lunak yang pengembang menggunakan untuk membuat game untuk konsol permainan video dan komputer pribadi. Fungsionalitas inti biasanya disediakan oleh mesin permainan mencakup mesin render (“renderer”) untuk grafis 2D atau 3D, mesin fisika atau tabrakan (dan tanggapan tabrakan), suara, script, animasi, kecerdasan buatan, jaringan, streaming, memori manajemen, threading, lokalisasi dukungan, dan grafik adegan. Proses pengembangan game sering dihemat, sebagian besar, dengan menggunakan kembali / mengadaptasi mesin permainan yang sama untuk membuat permainan yang berbeda, [1] atau untuk memudahkan permainan “port” untuk berbagai platform.
Tujuan
Mesin permainan menyediakan seperangkat alat pengembangan visual selain komponen perangkat lunak dapat digunakan kembali. Alat ini umumnya diberikan dalam lingkungan pengembangan terintegrasi untuk mengaktifkan disederhanakan, pesatnya perkembangan game dengan cara yang berbasis data. Pengembang game engine mencoba untuk “pra-invent the wheel” dengan mengembangkan suite perangkat lunak yang kuat yang meliputi banyak elemen adalah game developer mungkin perlu membangun sebuah permainan. Suite permainan yang paling mesin Menyediakan fasilitas yang memudahkan pengembangan, seperti grafik, suara, fisika dan AI fungsi. Mesin ini permainan kadang-kadang disebut “middleware” karena, seperti arti dari istilah bisnis, mereka menyediakan sebuah platform perangkat lunak yang fleksibel dan dapat digunakan kembali yang menyediakan semua fungsi inti yang dibutuhkan, langsung dari kotak, untuk mengembangkan aplikasi permainan sambil mengurangi biaya , kompleksitas, dan waktu-ke-pasar-semua faktor penting dalam industri video sangat kompetitif permainan [2] Gamebryo dan RenderWare adalah seperti program middleware banyak digunakan.. [3]
Seperti solusi middleware lainnya, mesin permainan biasanya menyediakan abstraksi platform, yang memungkinkan permainan yang sama yang akan dijalankan pada berbagai platform termasuk konsol game dan komputer pribadi dengan sedikit, jika ada, perubahan yang dilakukan ke kode sumber permainan. Seringkali, mesin permainan dirancang dengan arsitektur berbasis komponen yang memungkinkan sistem tertentu di mesin diganti atau diperpanjang dengan lebih khusus (dan sering lebih mahal) permainan middleware komponen seperti Havok untuk fisika, Miles Sound System untuk suara, atau Bink untuk video. Beberapa mesin permainan seperti RenderWare bahkan dirancang sebagai serangkaian komponen permainan longgar terhubung middleware yang dapat secara selektif dikombinasikan untuk menciptakan mesin kustom, bukan pendekatan yang lebih umum untuk memperluas atau menyesuaikan solusi terintegrasi fleksibel. Namun diperpanjang dicapai, itu tetap merupakan prioritas tinggi di mesin game karena berbagai macam kegunaan yang mereka diterapkan. Meskipun spesifisitas dari nama, mesin permainan yang sering digunakan untuk jenis lain dari aplikasi interaktif dengan real-time kebutuhan grafis seperti demo pemasaran, visualisasi arsitektur, simulasi pelatihan, dan lingkungan pemodelan. [4]
Beberapa mesin permainan hanya menyediakan kemampuan real-time 3D rendering bukan berbagai fungsi yang dibutuhkan oleh game. Mesin ini bergantung pada pengembang game untuk melaksanakan seluruh fungsi ini atau merakit dari komponen middleware permainan lainnya. Jenis mesin biasanya disebut sebagai “mesin grafis,” “mesin render,” atau “mesin 3D” bukan lebih menyeluruh istilah “mesin permainan.” Terminologi ini tidak konsisten digunakan sebagai banyak fitur lengkap mesin permainan 3D yang disebut hanya sebagai “mesin 3D.” Beberapa contoh mesin grafis adalah: Ruang Crystal, Genesis3D, Irrlicht, JMonkey Engine, Ogre, RealmForge, Truevision3D, dan Vision Engine. Permainan modern atau mesin grafis umumnya menyediakan grafik adegan, yang merupakan representasi berorientasi objek dari permainan dunia 3D yang sering menyederhanakan desain game dan dapat digunakan untuk rendering yang lebih efisien dari dunia maya yang luas.
Hardware Abstraction
Paling sering, mesin 3D atau sistem render di mesin permainan yang dibangun di atas antarmuka pemrograman aplikasi grafis (API) seperti Direct3D atau OpenGL yang menyediakan abstraksi perangkat lunak dari graphics processing unit (GPU) atau kartu video. Tingkat rendah perpustakaan seperti DirectX, Simple DirectMedia Layer (SDL), dan OpenAL juga umum digunakan dalam permainan karena menyediakan perangkat keras-independen akses ke perangkat keras komputer lainnya seperti perangkat input (mouse, keyboard, dan joystick), kartu jaringan, dan suara kartu. Sebelum grafis hardware-accelerated 3D, penyaji perangkat lunak telah digunakan. Software render masih digunakan di beberapa alat pemodelan atau untuk gambar diam-diberikan ketika akurasi visual dinilai lebih real-time kinerja (frame per detik) atau ketika perangkat keras komputer tidak memenuhi kebutuhan seperti dukungan shader.
Dengan munculnya perangkat keras pengolahan dipercepat fisika, fisika API berbagai seperti PAL dan ekstensi fisika dari Collada (format pertukaran untuk aset 3D) menjadi tersedia untuk menyediakan abstraksi perangkat lunak dari unit pengolahan fisika penyedia middleware yang berbeda dan platform konsol.
Sejarah
Sebelum mesin permainan, permainan yang biasanya ditulis sebagai entitas tunggal: sebuah game untuk Atari 2600, misalnya, harus dirancang dari bawah ke atas untuk membuat penggunaan optimal dari layar hardware ini rutin tampilan inti hari ini disebut kernel oleh retro pengembang. Platform lain memiliki rentang yang lebih, tapi bahkan ketika layar tidak perhatian, kendala memori biasanya menyabotase upaya untuk menciptakan desain data-berat bahwa kebutuhan mesin. Bahkan pada platform mengakomodasi lebih, sangat sedikit dapat digunakan kembali antara permainan. Kemajuan cepat arcade hardware yang merupakan ujung tombak pasar pada waktu berarti bahwa sebagian besar kode harus dibuang setelah itu pula, sebagai generasi berikutnya dari game akan menggunakan desain permainan yang sama sekali berbeda yang mengambil keuntungan dari tambahan sumber daya. Dengan demikian desain paling permainan di tahun 1980 dirancang melalui ruleset keras-kode dengan sejumlah kecil dari tingkat dan data grafis. Sejak zaman keemasan video game arcade, itu menjadi umum untuk video perusahaan game untuk mengembangkan in-house mesin permainan untuk digunakan dengan perangkat lunak pihak pertama. Dengan beberapa pengecualian seperti mesin RPG Maker ASCII itu, pihak ketiga mesin permainan tidak umum sampai munculnya komputer grafis 3D pada 1990-an.
Generasi pertama mesin grafis pihak ketiga atau penyaji (dan pendahulu untuk apa yang sekarang kita kenal sebagai mesin) didominasi oleh tiga pemain; BRender dari Software Argonaut, Renderware dari Kriteria Software Limited dan Lab Realitas RenderMorphics ‘. Lab Realitas adalah yang tercepat dari tiga dan adalah yang pertama yang akan diperoleh dalam sebuah langkah agresif oleh Microsoft. Tim RenderMorphics Servan Keondjian, Kate Seekings dan Doug Rabson kemudian bergabung dengan proyek Microsoft yang ternyata Lab Realitas ke Direct3D sebelum Keondjian dan Rabson kiri ke awal perusahaan lain middleware Software Qube. Renderware akhirnya dibeli oleh EA (Electronic Arts) tetapi absen oleh raksasa game.
“Mesin permainan” istilah muncul pada pertengahan 1990-an, terutama sehubungan dengan game 3D seperti penembak orang pertama (FPS). (Lihat juga:. Orang pertama mesin penembak) Begitulah popularitas Doom Id Software dan game Quake, daripada pekerjaan dari awal, pengembang lain berlisensi bagian inti dari perangkat lunak dan dirancang grafis mereka sendiri, karakter, senjata dan tingkat -“permainan isi” atau “aset permainan.” Pemisahan permainan spesifik aturan dan data dari konsep dasar seperti tabrakan dan entitas permainan berarti bahwa tim bisa tumbuh dan mengkhususkan.
Kemudian game, seperti id Software Quake III Arena dan 1998 Epic Game Unreal yang dirancang dengan pendekatan ini dalam pikiran, dengan mesin dan konten dikembangkan secara terpisah. Praktek teknologi seperti lisensi telah terbukti menjadi aliran pendapatan yang berguna tambahan untuk beberapa pengembang game, sebagai lisensi satu untuk mesin permainan high-end komersial dapat berkisar dari US $ 10.000 untuk jutaan dolar, dan jumlah pemegang lisensi dapat mencapai beberapa selusin perusahaan, seperti yang terlihat dengan Unreal Engine. Paling tidak, mesin dapat digunakan kembali membuat sekuel mengembangkan permainan lebih cepat dan mudah, yang merupakan keuntungan yang berharga di industri video game kompetitif. Meskipun ada persaingan yang kuat antara Epic dan id sekitar tahun 2000, sejak itu Epic Unreal Engine yang telah jauh lebih populer daripada id Tek 4 [5].
Mesin permainan modern adalah beberapa aplikasi yang paling kompleks tertulis, sering menampilkan puluhan sistem tersetel berinteraksi untuk memastikan pengalaman pengguna yang tepat dikontrol. Evolusi terus mesin permainan telah menciptakan pemisahan yang kuat antara rendering, scripting, karya seni, dan desain tingkat. Sekarang umum, misalnya, untuk tim pengembangan game khas untuk memiliki beberapa kali sebagai banyak seniman sebagai programmer yang sebenarnya [6].
Orang pertama permainan penembak tetap menjadi pengguna utama dari pihak ketiga mesin permainan, tetapi mereka sekarang juga digunakan dalam genre lain. Misalnya, peran-bermain video game The Elder Scrolls III: Morrowind dan Dark Age of Camelot MMORPG yang berdasarkan mesin Gamebryo, dan Lineage II MMORPG didasarkan pada Unreal Engine. Mesin permainan yang digunakan untuk permainan awalnya dikembangkan untuk konsol rumah juga, misalnya, mesin RenderWare digunakan dalam Grand Theft Auto dan waralaba Burnout.
Threading adalah mengambil lebih penting karena ke modern multi-core (misalnya Cell) dan tuntutan meningkat pada realisme. Thread khas melibatkan rendering, streaming, audio, dan fisika. Game balap telah biasanya berada di garis depan dari threading dengan mesin fisika berjalan dalam thread terpisah jauh sebelum subsistem inti lainnya dipindahkan, sebagian karena rendering dan terkait tugas perlu update di hanya 30-60 Hz. Sebagai contoh, di PlayStation 3, fisika berlari di Need For Speed pada 100 Hz dibandingkan Forza Motorsport 2 pada 360 Hz.
Meskipun istilah pertama kali digunakan pada 1990-an, ada sistem sebelumnya beberapa pada 1980-an yang juga dianggap sebagai permainan mesin, seperti Interpreter Permainan Petualangan Sierra (AGI) dan SCI sistem, sistem SCUMM LucasArts ‘dan mesin Freescape Insentif Software . Tidak seperti mesin permainan yang paling modern, mesin permainan tidak pernah digunakan dalam setiap produk pihak ketiga (kecuali untuk sistem SCUMM yang dilisensikan ke dan digunakan oleh Hiburan humongous).
Tren terbaru
Sebagai permainan teknologi mesin matang dan menjadi lebih user-friendly, aplikasi mesin permainan telah memperluas cakupannya. Mereka sekarang digunakan untuk permainan serius: visualisasi, pelatihan, aplikasi simulasi medis, dan militer [7] Untuk memfasilitasi aksesibilitas ini, platform perangkat keras baru kini sedang ditargetkan oleh mesin permainan, termasuk ponsel (misalnya ponsel Android, iPhone) dan. web browser (misalnya WebGL, Shockwave, Flash, Trinigy yang WebVision, Silverlight, Persatuan Web Player, O3D dan murni DHTML). [8]
Selain itu, mesin permainan masih terus dibangun di atas bahasa tingkat tinggi seperti Java dan C # /. NET (misalnya TorqueX, dan Visual3D.NET) atau Python (Panda3D). Seperti game 3D paling kaya sekarang kebanyakan GPU-terbatas (yaitu dibatasi oleh kekuatan kartu grafis), perlambatan potensial karena overhead terjemahan bahasa tingkat tinggi menjadi diabaikan, sementara keuntungan produktivitas yang ditawarkan oleh bahasa-bahasa ini bekerja untuk mesin permainan manfaat pengembang ‘[9]. Kecenderungan terakhir ini didorong oleh perusahaan seperti Microsoft untuk mendukung pengembangan game Indie. Microsoft mengembangkan XNA SDK sebagai pilihan untuk semua permainan video yang dirilis di Xbox dan produk terkait. Ini termasuk Xbox Live Indie Games [10] saluran yang dirancang khusus untuk pengembang yang lebih kecil yang tidak memiliki sumber daya yang luas yang diperlukan untuk game kotak untuk dijual di rak ritel. Hal ini menjadi lebih mudah dan lebih murah dari sebelumnya untuk mengembangkan mesin game untuk platform yang mendukung kerangka kerja dikelola. [11]
Permainan Middleware
Dalam arti lebih luas dari mesin panjang, permainan itu sendiri dapat digambarkan sebagai middleware. Dalam konteks video game, namun “middleware” Istilah ini sering digunakan untuk merujuk pada subsistem fungsi dalam mesin permainan. Beberapa middleware permainan tidak hanya satu hal tapi apakah itu lebih meyakinkan atau lebih efisien daripada middleware tujuan umum. Sebagai contoh, SpeedTree digunakan untuk membuat pohon realistis dan vegetasi dalam video game role-playing The Elder Scrolls IV: Oblivion [12] dan Partikel Fork diperoleh digunakan untuk simulasi dan membuat Sistem waktu Partikel nyata efek visual atau efek partikel di Sid Meier Peradaban V. [13]
Keempat paket middleware yang paling banyak digunakan [14] yang menyediakan subsistem fungsi termasuk Bink Alat Permainan RAD ‘, FMOD Firelight, Havok, dan Scaleform GFX. Alat Permainan RAD mengembangkan Bink untuk rendering video dasar, bersama dengan Miles audio, dan Nenek render 3D. FMOD cahaya api adalah biaya rendah audio yang kuat perpustakaan dan toolset. Havok menyediakan sistem simulasi fisika yang kuat, bersama dengan suite solusi animasi dan perilaku. Scaleform menyediakan GFX untuk kinerja tinggi Flash UI, bersama dengan solusi berkualitas tinggi pemutaran video, dan Method Editor Input (IME) add-on untuk dalam game chat support Asia.
Beberapa middleware berisi kode sumber penuh, yang lain hanya menyediakan referensi API untuk perpustakaan biner dikompilasi. Beberapa program middleware dapat lisensi dengan cara baik, biasanya untuk biaya yang lebih tinggi untuk kode sumber lengkap.
Massively Multiplayer Online Game
The Game Engine (atau Middleware) untuk secara besar-besaran online multiplayer game (MMOs, MMOGs) jauh lebih kompleks daripada untuk single-player video game. Secara teknis setiap mesin permainan normal dapat digunakan untuk mengimplementasikan sebuah game MMO dengan menggabungkan dengan MMO middleware. Meningkatnya popularitas MMOGs memacu pengembangan paket MMO middleware. Beberapa MMO middleware paket perangkat lunak sudah termasuk mesin permainan, sementara yang lain hanya memberikan jaringan dan karena itu harus dikombinasikan dengan mesin permainan untuk membuat game MMO. Beberapa solusi MMO menonjol middleware meliputi:
Abyssal Engine (solusi MMO penuh)
Bigworld Teknologi [15] (klien / MMO server tertentu)
Keluar Neutron Games [16]
HeroEngine [17]
Monumental Permainan
Multiverse Jaringan
Q (klien-saja, tapi dengan solusi server sebagai ‘Mesias’) [18]
RedDwarf Server (open source)
Visi Mesin [19]
Pertama-orang jujur mesin
Artikel utama: orang mesin penembak Pertama
Sebuah subset yang terkenal adalah mesin permainan 3D first-person shooter (FPS) mesin permainan. Pengembangan inovatif dalam hal kualitas visual dilakukan dalam game FPS pada skala manusia. Sementara penerbangan dan mengemudi simulator dan real-time strategy (RTS) game semakin memberikan realisme pada skala besar, penembak orang pertama berada di garis depan komputer grafis pada skala ini lebih kecil.
Perkembangan FPS mesin grafis yang muncul dalam permainan dapat ditandai dengan peningkatan yang stabil dalam teknologi, dengan beberapa terobosan. Upaya mendefinisikan generasi yang berbeda menyebabkan pilihan sewenang-wenang dari apa yang merupakan versi yang sangat modifikasi dari sebuah ‘mesin tua’ dan apa adalah mesin baru.
Klasifikasi rumit sebagai mesin permainan berbaur teknologi lama dan baru. Fitur dianggap maju dalam permainan baru satu tahun menjadi standar yang diharapkan tahun depan. Permainan dengan campuran generasi tua dan fitur yang lebih baru adalah norma. Misalnya Jurassic Park: pelanggar (1998) memperkenalkan fisika untuk game FPS, tapi itu tidak menjadi umum sampai sekitar 2002. Fraksi Merah (2001) menampilkan dinding dirusak dan tanah, sesuatu yang masih belum umum di mesin tahun kemudian (misalnya dalam Unreal Tournament 2004 ada masih ada benda dirusak). Battlezone (1998) dan Battlezone II: Combat Commander (1999) menambahkan kendaraan tempur berbasis campuran FPS biasa, yang tidak memukul mainstream sampai nanti. Suku 2, Battlefield 1942, Halo: Combat Evolved dan Unreal Tournament 2004 sepenuhnya menyadari potensi untuk kendaraan-tempur dan integrasi orang jujur pertama.
RPG mesin
RPG pembuat
Sim RPG pembuat
Visual Novel mesin
Karena sifat kurang grafis yang intensif permainan visual novel, mesin visual novel cenderung sangat sederhana dibandingkan dengan mesin game FPS. Mesin visual novel permainan meliputi:
Visual Novelty
KiriKiri
NScripter
Ren’Py
Digital Novel Markup Language
Sejarah Perkembangan Video Games
Posted on: Maret 18, 2012
Sejarah Perkembangan Video GamesVideo games pertama kali diperkenalkan pada tahun 1971 sebagai medium hiburan yang bersifat komersial. Pada akhir tahun 1970an dan awal tahun 1980an, video games menjadi sebuah dasar yang penting bagi industri hiburan di Amerika Serikat, Jepang, dan Eropa. Sejak masa kejatuhan dalam bidang industri pada tahun 1983 dan kebangkitannya dua tahun kemudian, industri video game telah mengalami perkembangan selama dua dekade dan menjadi industri yang berharga $10 miliar, yang menjadi saingan dengan industri ‘motion picture’ sebagai industri hiburan yang paling berprofit besar.Pada tahun 1952, A.S. Douglas menulis untuk gelar PhD di University of Cambridge jurusan Human-Computer Interraction. Douglas menciptakan permainan komputer grafis yang diberi nama Tic-Tac-Toe. Permainan ini deprogram pada komputer EDSAC vacuum-tube yang memiliki tampilan tabung sinar katode.William Higinborham menciptakan video game pertama pada tahun 1958. Permainan ini diberi judul “Tennis for Two”, diciptakan dan dimainkan di osiloskop Brookhaven National Laboratory. Pada tahun 1962, Steve Russell menciptakan SpaceWar! Permainan ini merupakan permainan pertama yang dimaksudkan untuk pemakaian komputer. Russel menggunakan MIT PDP-1 komputer mainframe untuk meciptakan permainan ini.Pada 1967, Ralph Baer menciptakan video game pertama yang dimaikan dengan televisi, sebuah permainan yang diberi nama Chase. Ralph Baer akhirnya menjadi bagian dari Sanders Associates, sebuah perusahaan elektronik militer. Ralph mencetuskan idenya untuk pertama kali pada 1951, saat sedang bekerja untuk Loral, sebuah perusahaan komputer.Pada 1971, Nolan Bushnell bersama dengan Ted Dabney, menciptakan permainan arcade yang pertama. Permainan ini diberi nama Computer Space, yang diciptakan berdasarkan pada permainan SpaceWar! Permainan arcade Pong diciptakan oleh Nolan Bushnell (dengan bantuan Al Alcorn) setahun kemudian pada tahun 1972. Nolan Bushnell dan Ted Dabney memulai dengan Atari Computer pada tahun yang sama. Pada tahun 1975, Atari kembali meluncurkan Pong sebagai home video game.Tahun 1972, hiburan pertama video game komersial dapat dimainkan di rumah, Odyssey, diluncurkan oleh Magnavox dan didesain oleh Ralph Baer. Permainan mesin ini aslinya didesain pada saat Ralph Baer masih berada di Sanders Associates pada tahun 1966, Baer mengurus untuk mendapatkan ijin legalnya setelah ditolak oleh Sanders Associates. Permainan Odyssey deprogram dengan dua belas permainan.Pada tahun 1976, Fairchild meluncurkan programmable home game yang pertama dan diberi nama Fairchild Video Entertainment System atau Channel F. Channel F merupakan salah satu dari electronic system yang pertama menggunakan microchip yang diciptakan oelh Robert Noyce untuk Fairchild Semiconductor Corporation.
Internet berbasis UUCP
Posted on: Februari 15, 2011
UUCP adalah singkatan untuk Unix-to-Unix Copy. Istilah ini umumnya mengacu ke suite program komputer dan protokol yang memungkinkan eksekusi perintah jarak jauh dan transfer file, email dan netnews antar komputer. Secara khusus, UUCP merupakan salah satu program dalam suite, tetapi menyediakan antarmuka pengguna untuk meminta operasi file copy. Suite UUCP juga mencakup uux (user interface untuk eksekusi perintah jarak jauh), uucico (program komunikasi), uustat (laporan statistik aktivitas terakhir), uuxqt (jalankan perintah dikirim dari mesin remote), dan uuname (laporan nama uucp dari lokal sistem). Meskipun UUCP pada awalnya dikembangkan pada dan paling erat hubungannya dengan Unix, implementasi UUCP ada untuk beberapa sistem operasi lain, termasuk Microsoft MS-DOS, Digital VAX / VMS, Commodore’s AmigaOS, dan Mac OS.
disini bisa didownload di
http://www.2shared.com/document/_D6BcBvW/tugas_softskill2.html
SEJARAH ANTI VIRUS DI KOMPUTER
Posted on: Januari 13, 2011
Antivirus atau perangkat lunak anti-virus digunakan untuk mencegah, mendeteksi dan menghapus virus komputer, worm, dan kuda trojan. Hal ini juga dapat mencegah dan menghapus adware, spyware, dan bentuk-bentuk malware. Halaman ini berbicara tentang perangkat lunak yang digunakan untuk pencegahan dan penghapusan ancaman tersebut, daripada keamanan komputer dilaksanakan dengan metode perangkat lunak.
Berbagai strategi biasanya digunakan. Signature deteksi berbasis melibatkan mencari pola yang dikenal data dalam kode dieksekusi. Namun, dimungkinkan untuk komputer yang akan terinfeksi malware baru yang tidak ada tanda tangan belum diketahui. Untuk mengatasi ancaman seperti zero-day yang disebut, heuristik dapat digunakan. Salah satu jenis pendekatan heuristik, tanda tangan generik, dapat mengidentifikasi virus baru atau varian dari virus yang ada dengan mencari kode berbahaya yang dikenal, atau sedikit variasi kode tersebut, dalam file. Beberapa perangkat lunak antivirus juga dapat memprediksi apa file akan melakukannya dengan menjalankan di kotak pasir dan menganalisis apa yang dilakukan untuk melihat apakah melakukan tindakan berbahaya.
Tidak peduli bagaimana perangkat lunak antivirus bisa berguna, kadang-kadang dapat memiliki kelemahan. Perangkat lunak antivirus dapat mengganggu kinerja komputer. pengguna berpengalaman mungkin juga memiliki kesulitan memahami petunjuk dan keputusan bahwa perangkat lunak antivirus menyajikan mereka dengan. Sebuah keputusan yang tidak benar dapat menyebabkan pelanggaran keamanan. Jika perangkat lunak antivirus mempekerjakan deteksi heuristik, kesuksesan tergantung pada pencapaian keseimbangan yang tepat antara positif palsu dan negatif palsu. positif palsu dapat sebagai merusak sebagai negatif palsu. Akhirnya, perangkat lunak antivirus umumnya berjalan pada level kernel yang sangat terpercaya dari sistem operasi, membuat potensi jalan serangan.
SEJARAH
Sebagian besar dari virus komputer yang ditulis pada tahun 1980 awal dan pertengahan terbatas pada diri-reproduksi dan tidak memiliki rutinitas kerusakan khusus dibangun ke kode. Itu berubah ketika programmer lebih banyak berkenalan dengan pemrograman virus dan menciptakan virus yang dimanipulasi atau bahkan menghancurkan data pada komputer yang terinfeksi.
Ada klaim bersaing untuk inovator produk antivirus pertama. Mungkin penghapusan didokumentasikan publik pertama dari virus komputer di alam liar dilakukan oleh Bernd Fix pada tahun 1987.
Fred Cohen, yang menerbitkan salah satu koran akademis pertama mengenai virus komputer pada tahun 1984, mulai mengembangkan strategi untuk perangkat lunak antivirus pada tahun 1988 yang dijemput dan dilanjutkan oleh pengembang perangkat lunak kemudian antivirus.
Juga pada tahun 1988 sebuah milis bernama VIRUS-L dimulai pada jaringan / BITNET EARN mana virus baru dan kemungkinan mendeteksi dan menghilangkan virus telah dibahas. Beberapa anggota milis ini seperti John McAfee atau Eugene Kaspersky kemudian mendirikan perusahaan perangkat lunak yang dikembangkan dan menjual perangkat lunak antivirus komersial.
Sebelum konektivitas internet tersebar luas, virus yang biasanya disebarkan melalui disket yang terinfeksi. Perangkat lunak antivirus mulai digunakan, tetapi telah diupdate relatif jarang. Selama waktu ini, pada dasarnya virus checkers harus memeriksa file yang dapat dieksekusi dan sektor boot dari floppy disk dan hard disk. Namun, seperti penggunaan internet menjadi umum, virus mulai menyebar online.
Selama bertahun-tahun telah menjadi mutlak untuk perangkat lunak antivirus untuk memeriksa sebuah peningkatan berbagai file, bukan hanya executable, karena beberapa alasan:
* Macro Powerfull digunakan dalam aplikasi pengolah kata, seperti Microsoft Word, disajikan risiko. Para penulis virus dapat menggunakan macro untuk menulis virus tertanam di dalam dokumen. Ini berarti bahwa komputer sekarang bisa juga berisiko dari infeksi dengan membuka dokumen dengan macro terpasang tersembunyi
* Kemudian program email, dalam Microsoft Outlook Express dan Outlook tertentu, yang rentan terhadap virus melekat dalam tubuh email itu sendiri. Sebuah komputer pengguna bisa terinfeksi hanya dengan membuka atau melihat pratinjau pesan.
Seperti biasa-on koneksi broadband menjadi norma, dan virus semakin banyak dibebaskan, menjadi penting untuk memperbarui catur virus lebih banyak dan lebih sering. Bahkan kemudian, virus nol-hari baru bisa menjadi luas sebelum perusahaan antivirus merilis update untuk melindungi terhadap itu.

